安谋科技发布 Cortex-M42 处理器及星辰 100e 原型平台,面向边缘 AI 应用的 MCU 核心。处理器集成 Helium 向量扩展,向量计算能力提升 3 倍,能效提升 2 倍。在 TSMC 22ULL 工艺 150MHz 频率下,相比 Cortex-M52 面积减少 10%,功耗降低 15%。
与 Ethos-U55 NPU 协同时,自动语音识别推理性能提升 340 倍,目标识别提升 132 倍,关键字检测提升 95 倍。
关键参数
| 参数 | 数值 | 说明 |
|---|---|---|
| 向量计算能力提升 | 3 倍 | 集成 Helium 向量扩展后相比标量运算 |
| 向量能效提升 | 2 倍 | 单位功耗下的向量运算吞吐 |
| 面积减少 | 10% | 对比 Cortex-M52,TSMC 22ULL 工艺 150MHz |
| 功耗降低 | 15% | 对比 Cortex-M52,TSMC 22ULL 工艺 150MHz |
| 语音识别性能提升 | 340 倍 | M42+Ethos-U55 相比单独 M42 |
| 目标识别性能提升 | 132 倍 | M42+Ethos-U55 相比单独 M42 |
| 关键字检测性能提升 | 95 倍 | M42+Ethos-U55 相比单独 M42 |
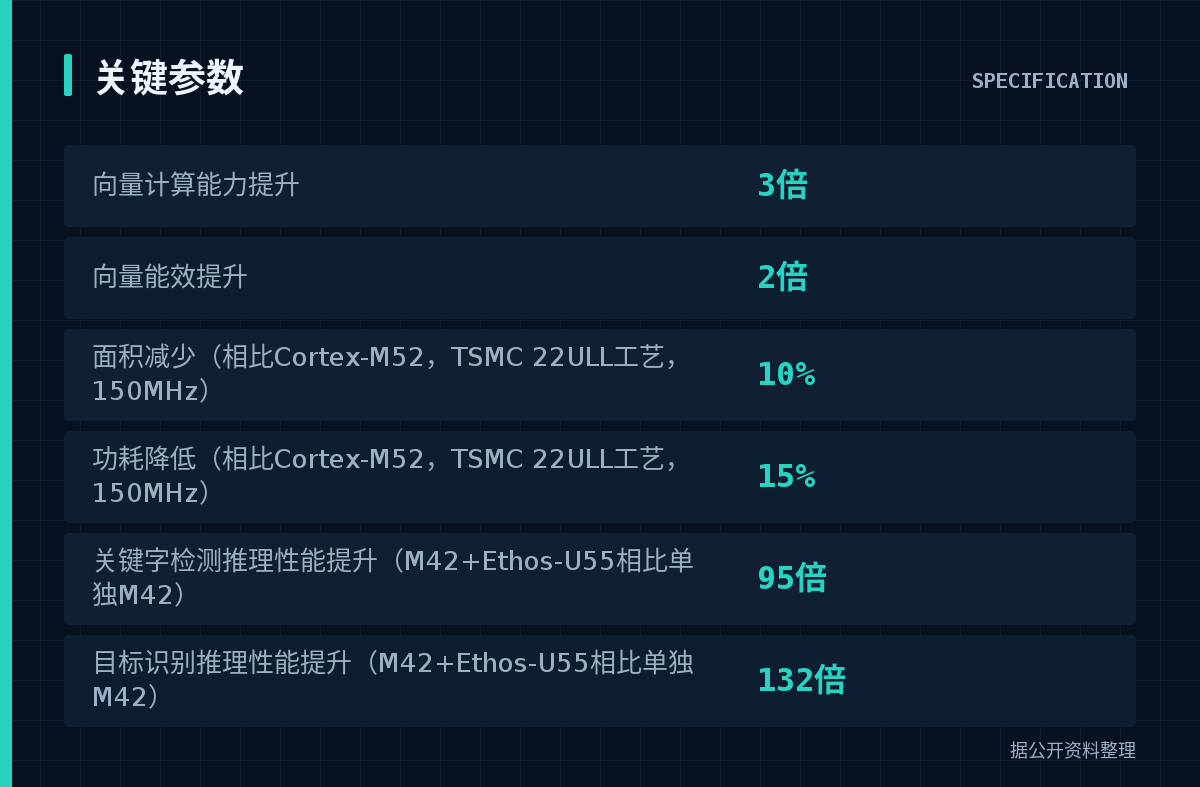
图:关键参数图
技术拆解
Helium 向量扩展架构
Cortex-M42 基于 Armv8.1-M 架构,集成 Helium 向量扩展。Helium 在 2019 年随该架构推出,是专为低功耗微控制器设计的 SIMD 指令集。它通过向量寄存器在单周期内对多个数据元素执行相同操作,适合信号处理和机器学习推理中的矩阵乘法、卷积、激活函数计算。
图:架构与数据路径
相比纯标量运算,Cortex-M42 的向量计算能力提升 3 倍,能效提升 2 倍。这意味着在相同功耗预算下可完成更多并行计算任务,或在相同性能下降低系统功耗。Helium 支持整数和浮点运算,为量化神经网络和传统 DSP 算法提供硬件加速。
ACI 自定义指令扩展
Cortex-M42 支持 ACI(Arm Custom Instructions)自定义指令机制,允许 SoC 设计者为特定应用添加硬件加速逻辑。这为智能传感器融合、加密算法或专用编解码器提供了灵活性,无需修改核心架构即可扩展指令集。
CPU 与 NPU 协同架构
Cortex-M42 基于 AHB 总线与外设和存储器通信,架构设计强调与 Ethos-U55 NPU 的协同工作。Ethos-U55 是 Arm 的微型 NPU,专为边缘设备的深度学习推理设计。当 CPU 与 NPU 协同时,推理任务中的卷积层由 NPU 处理,预处理和后处理由 CPU 完成,避免数据在不同计算单元间频繁搬运。
在自动语音识别任务中,M42+Ethos-U55 的推理性能比单独 M42 提升 340 倍,目标识别场景提升 132 倍,关键字检测场景提升 95 倍。这些倍数反映了 NPU 在卷积密集型任务中的效率优势,也说明 CPU 单独处理神经网络时受限于标量或向量运算的带宽。
工艺节点与功耗特性
在 TSMC 22ULL 工艺节点、150MHz 工作频率下,Cortex-M42 相比 Cortex-M52 面积减少 10%,功耗降低 15%。22ULL 是超低漏电工艺,适合电池供电的长续航设备。面积缩减来自架构优化和对冗余逻辑的裁剪,功耗降低受益于更短的关键路径和向量扩展的能效提升。
横向对比
| 方案 | 技术路线 | 成熟度 | 适用场景 |
|---|---|---|---|
| Cortex-M42+Helium | SIMD 向量扩展集成于 CPU | Helium 自 2019 年推出,已有多代产品验证 | 边缘 AI 推理、信号处理、通用 MCU 应用 |
| Cortex-M42+Ethos-U55 | CPU 与微型 NPU 协同 | Ethos-U 系列在可穿戴和 IoT 设备中量产 | 卷积密集型深度学习推理 |
| 纯 DSP 加速 | 专用 DSP 核心处理信号 | DSP 架构成熟,但需额外芯片面积 | 音频、无线基带、传感器融合 |
| FPGA 软核 | 可重构逻辑实现算法加速 | 灵活性高,功耗和成本较高 | 原型验证、小批量定制应用 |
对工程师意味着什么
选型考量
Cortex-M42 适合需要本地推理的边缘设备,如智能传感器、工业控制器、消费电子。Helium 向量扩展降低了在 MCU 上运行轻量级神经网络的门槛,无需外挂独立 AI 加速器。对于已使用 Cortex-M 系列的开发者,迁移到 M42 可复用现有工具链和代码库,同时获得向量运算的性能提升。
功耗与散热
在 TSMC 22ULL 工艺下,M42 的功耗相比 M52 降低 15%,对电池供电设备延长续航时间有直接帮助。150MHz 工作频率下无需主动散热即可在密闭外壳中稳定运行。如果 SoC 集成了 Ethos-U55,需评估 NPU 推理时的峰值功耗,确保电源管理单元能够应对瞬时负载。
接口生态
基于 AHB 总线的互联架构与 Arm 生态中的标准外设 IP 兼容,包括 UART、I2C、SPI、ADC、定时器等。这简化了 SoC 设计阶段的集成工作。对于需要高速数据传输的应用,如摄像头接口或无线通信,需结合 DMA 控制器减少 CPU 干预,避免向量运算被频繁中断。
工具链与软件栈
Cortex-M42 支持 Arm 的 CMSIS-NN 和 CMSIS-DSP 库,这两个库针对 Helium 指令集优化了常用的神经网络算子和信号处理函数。开发者可直接调用库函数,编译器会自动生成向量化代码。星辰 100e 原型平台提供了从算法到硬件的端到端开发环境,2027 年计划推出更高性能的下一代平台。
对于使用 TensorFlow Lite for Microcontrollers 或 PyTorch Mobile 的开发者,需确认量化后的模型能否在 M42+Ethos-U55 上高效运行。NPU 对算子支持有限,某些自定义层仍需回退到 CPU,这会影响端到端延迟。
成本与供应
Cortex-M42 面积减少 10% 直接降低了芯片制造成本。安谋科技在中国市场将其命名为星辰 STAR-MC3,Arm 则纳入全球产品路线图,授权客户可选择不同的供应渠道和服务支持。对于量产项目,需与 IP 授权商确认技术支持期限和芯片代工厂的产能安排。
尚待验证
Cortex-M42 的实际硅片面积数值,当前只有相对 Cortex-M52 的百分比,需流片后实测绝对面积,用于评估在不同封装下的集成密度。
Cortex-M42 的功耗绝对值,材料给出相对降低幅度,但实际应用需要知道 150MHz 下的毫瓦级功耗,以及动态调频下的功耗曲线。
ACI 自定义指令的具体实现方式和性能影响,需确认指令扩展的延迟、面积开销,以及与 Helium 向量扩展的协同效率。
星辰 100e 平台在实际芯片流片后的性能表现,原型平台可能使用 FPGA 或仿真环境,流片后的时序、功耗、良率需验证。
与 Cortex-M33 在相同工艺节点下的面积和功耗对比,M33 是广泛部署的前代产品,缺少横向对比会影响选型决策。
不同工艺节点下的 PPA 特性,材料只给出 TSMC 22ULL 的数据,如果迁移到其他工艺,面积、功耗、频率的权衡需重新评估。
Helium 在不同数据类型计算中的具体加速倍数,材料给出整体 3 倍提升,但量化神经网络和浮点 DSP 对不同数据类型的性能需求不同,分类型的性能数据对算法选型更有指导意义。
审核编辑 黄宇