嵌入式系统里有一类开销,往往不来自算力,而来自"每次都要去翻一遍低速存储"——配置参数存在 SPI Flash 或 EEPROM 中,业务模块却要反复读取网络地址、波特率、工作模式。一次读取是 ms 级,一天读几万次,累计延迟就变成了系统响应里的固定负担。
LRU(Least Recently Used,最近最少使用)缓存解决的就是这个矛盾:用有限的高速内存,留住最常被访问的那部分数据。它不追求把数据全量装进来,而是靠一条淘汰规则做精细化管理——空间满了,就移走最久没被碰过的那一条。
本文基于EASY-EAI工程师真实项目经验,从 LRU 的淘汰逻辑讲起,拆解哈希表 + 双向链表这一标准架构为什么能做到 O(1),给出 int 基础版与 void* 泛型版的 C 语言实现,并以设备配置参数缓存为例,完整演示一次从 Flash 慢速读取到内存命中的落地过程。
01
从一个书架说起:LRU 的淘汰规则
想象一个只能放 10 本书的书架。读者归还一本新书时,如果架子已满,就得决定移走哪一本。合理的做法是移走最近最少被借阅的那本——它已经很久没人关心,短期内大概率也不会有人借。
这背后是 LRU 的底层假设:最近被频繁访问的数据,未来大概率还会被频繁访问;很久没被访问的数据,短期内也不会被用到。
缓存本质是一层高速中间存储,把高频访问的数据从低速介质复制到高速介质,后续访问直接读取,规避低速 IO。而 LRU 是缓存淘汰策略的一种,规则只有两条:
访问一个数据时,把它标记为最近使用
空间已满又要存入新数据时,淘汰最久未被访问的那一条
02
为什么嵌入式更需要 LRU
相比通用计算机,嵌入式场景下这套策略的收益更直接,原因集中在三点:
低速 IO 瓶颈明显。 嵌入式存储多为 SPI Flash、EEPROM,读写速度比内存慢几个数量级,缓存带来的性能收益更显著。
内存资源极度受限。 设备内存通常只有几 MB 到几十 MB,无法全量加载数据,必须通过淘汰策略做精细化管理——这恰恰是 LRU 的适用场景,而不是"内存够大就不必缓存"的例外。
实时性要求高。 工业控制、安防等场景对响应时延敏感,通过缓存保证高频操作的快速响应,直接影响系统可用性。
03
工作原理:
哈希表 + 双向链表如何做到 O(1)
把缓存看成一张热门排行榜
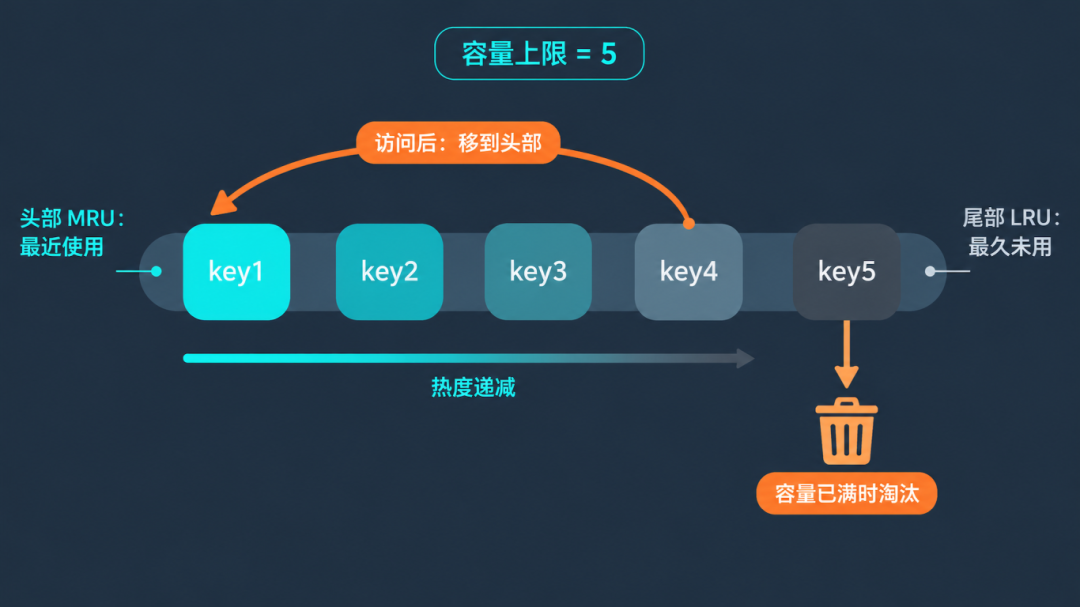
LRU 的内部顺序可以理解成一条有容量上限的排行榜:
头部:最近刚被访问的数据,热度最高
尾部:最久没被访问的数据,热度最低
每次访问命中,就把该数据重新排到头部
新数据一律从头部加入;容量已满,则移除尾部
两种结构各自解决一个问题
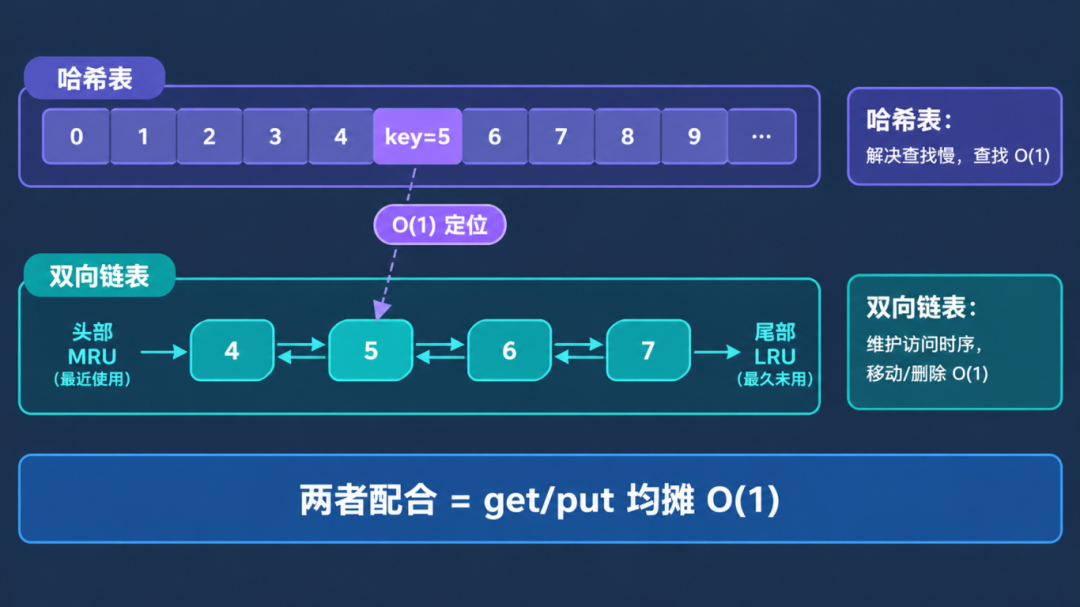
要高效实现上述规则,单靠一种结构不够,需要两种配合:
关键点在于:命中后"把中间某个节点移到头部",如果是单向链表,需要先遍历找到前驱节点;双向链表直接改相邻指针即可,固定几步操作完成,不需要遍历。两者配合,才同时实现了快速查找与快速更新访问顺序。
get / put 的完整流程
访问数据 X 时:
1.通过哈希表判断 X 是否在缓存中
2.命中:将对应节点从链表当前位置移到头部,返回数据
3.未命中:从低速存储加载 X
若缓存已满:先移除链表尾部节点,同时从哈希表删除对应键
将 X 封装为新节点,插入链表头部,同时写入哈希表
4.返回 X 的数据
04
C 语言实现:
从 int 基础版到 void* 泛型
基础版:数组直接寻址
先从最简版本入手,键和值均为int,哈希表用数组直接寻址,便于把注意力放在算法本身。
typedefstructCacheNode{ intkey; intvalue; structCacheNode*prev; // 前驱指针 structCacheNode*next; // 后继指针} CacheNode;typedefstruct{ intcapacity; // 缓存最大容量 intsize; // 当前已使用大小 CacheNode *head; // 链表头(最近使用) CacheNode *tail; // 链表尾(最久未用) CacheNode **hashmap; // 存储节点指针,用于快速查找} LRUCache;
moveToHead()是整个 LRU 的核心操作,每次命中都要调用:
void moveToHead(LRUCache *cache, CacheNode *node) { if(node == cache->head)return; // 已在头部 // 1. 从当前位置摘除 if(node->prev) node->prev->next = node->next; if(node->next) node->next->prev = node->prev; // 2. 若摘的是尾节点,同步更新尾指针 if(node == cache->tail) cache->tail= node->prev; // 3. 插入头部 node->prev = NULL; node->next = cache->head; if(cache->head) cache->head->prev = node; cache->head= node; // 4. 缓存为空时同步更新尾部 if(cache->tail== NULL) cache->tail= node;}
lruGet()命中后调moveToHead()再返回值;lruPut()分三种情况:键已存在则更新值并移到头部、缓存已满则淘汰尾部再插新节点、否则直接插头部并写入哈希表。
泛型版:void* 与内存生命周期
基础版只支持 int,但工程中经常要缓存字符串、结构体。改用void*通用指针即可:
typedefstructCacheNode{ intkey; void *value; // 可指向任意类型数据 int value_len; // 数据长度,用于拷贝与内存管理 structCacheNode*prev; structCacheNode*next;} CacheNode;
由此带来三处必须处理的内存动作:
存入时:传入数据指针与长度,内部申请内存并memcpy拷贝,避免外部释放后形成野指针
取出时:返回数据指针,或由调用者提供缓冲区拷贝
淘汰时:必须先free(node->value),再free(node)—— 这是嵌入式场景的重点,漏掉前者就是内存泄漏
更新已存在的键同理:先释放旧值内存,再重新分配、拷贝、更新value_len,最后移到头部。
05
容量 2 的完整演示:
一次淘汰是怎么发生的
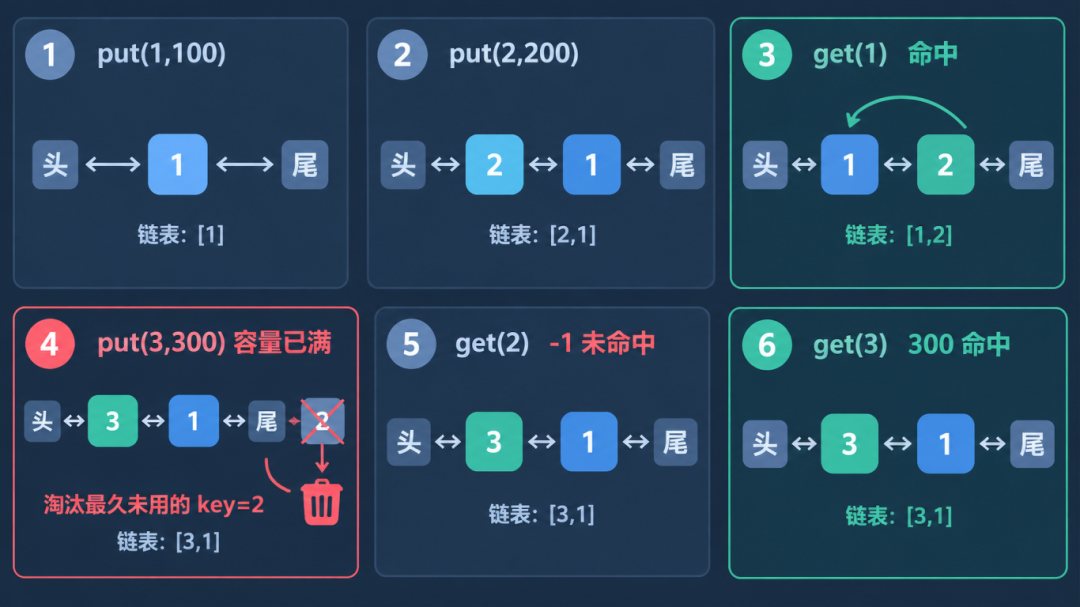
用容量为 2 的缓存走一遍全流程,淘汰逻辑最直观:
intmain() { LRUCache *cache = lruCreate(2); lruPut(cache,1,100); //头部 [1] lruPut(cache,2,200); //头部 [2,1] 尾部 printf("键1的值:%d\n", lruGet(cache,1)); //命中,变为 [1,2] lruPut(cache,3,300); //容量已满,淘汰最久未用的键2→ [3,1] printf("键2的值:%d\n", lruGet(cache,2)); //-1,已被淘汰 printf("键3的值:%d\n", lruGet(cache,3)); //300 return0;}
输出:
键1的值: 100键2的值: -1键3的值: 300
注意第 3 步:get(1)命中后把键 1 移到头部,键 2 因此变成尾部;第 4 步加入键 3 时,被淘汰的是键 2 而非键 1。这说明 LRU 淘汰的依据是"最近一次访问的时间",不是"最初放入的时间"。
06
落地场景:
设备配置参数缓存
把上面的实现放进一个真实嵌入式场景:配置参数存在 SPI Flash 中,共 10 项(IP 地址、子网掩码、网关、波特率、日志开关、日志等级、设备型号、服务端口、用户名、密码),每次读取都是 ms 级慢速 IO;而网络参数、工作模式等会被业务频繁读取。
设缓存容量为 3(模拟内存受限),高频访问的配置即可直接从内存读取,耗时降到 us 级,访问延迟降低 1~2 个数量级。
带缓存的读取函数lru_cfg_get()分两支:哈希表命中则move_to_head()后直接返回并打印[缓存命中];未命中则调用flash_read_cfg()从 Flash 加载,创建新节点,容量满时淘汰尾部,插入头部并写入哈希表,打印[缓存淘汰]。销毁函数需遍历链表逐个释放节点,再释放哈希表数组与缓存结构体本身。
运行结果:
===== 第一轮读取(全未命中,加载到缓存)=====[缓存未命中] 从Flash读取 cfg_id=0[缓存未命中] 从Flash读取 cfg_id=1[缓存未命中] 从Flash读取 cfg_id=2===== 第二轮读取(命中热点配置)=====[缓存命中] cfg_id=0, value=192.168.1.100[缓存命中] cfg_id=0, value=192.168.1.100===== 新增配置,触发淘汰=====[缓存未命中] 从Flash读取 cfg_id=3[缓存淘汰] 淘汰 cfg_id=1===== 验证淘汰结果=====[缓存未命中] 从Flash读取 cfg_id=1[缓存销毁] 所有资源已释放
一轮读取建立缓存、二轮连续命中、新增触发淘汰、再读被淘汰项重新回源——这是 LRU 在设备上最典型的运行形态。完整可运行代码见文末链接原贴。
07
模型支持范围与实测性能
Q:数据量增大,访问会变慢吗?
A:算法层面不会。 标准哈希表 + 双向链表的实现,get / put 的均摊时间复杂度都是 O(1):哈希表直接寻址一次定位,链表移动只改相邻指针、固定几步完成,不需要遍历。只要哈希表设计合理,缓存容量从 100 扩到 10 万,单次操作耗时不会出现数量级上升。
但真实系统的体验差异来自另外三处:
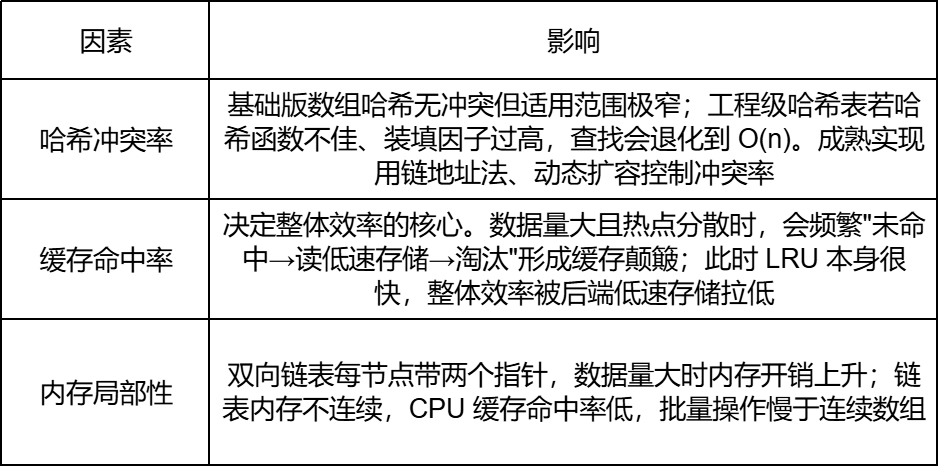
本文实现的三条边界
哈希表简单:数组直接下标寻址,仅支持非负整数键,且键范围不能太大
类型受限:基础版值只能是 int;泛型版支持任意类型,但需自行管理内存生命周期
非线程安全:多线程并发读写会出现链表指针错乱、哈希表不一致
工程化路径
哈希表优化 —— 使用成熟通用哈希表,支持任意类型键、自动处理冲突、动态扩容
线程安全 —— 读写锁保护,读多写少场景优先读写锁
内存池化 —— 内存池预分配节点,避免频繁 malloc/free 产生碎片
嵌入式定制 —— 资源极度受限时用数组模拟双向链表,完全不用动态内存分配,确定性更强
结语
LRU 之所以经典,是因为它解决了一个基础矛盾:如何用有限的高速存储空间,最大化提升数据访问效率。这一点在内存受限、IO 低速的嵌入式系统中价值尤为突出——从 ms 级 Flash 读取到 us 级内存命中,中间只隔了一层容量可能只有 3 项的缓存。
对工程团队而言,值得带走的判断有两个:一是哈希表 + 双向链表的组合是标准架构,哈希表保证查找、双向链表维护时序,两者配合才有 O(1);二是教学实现与可量产实现之间差的是内存管理、线程安全与哈希冲突处理,而非算法本身。理解这两点,配置读取、日志缓存、业务数据访问等场景都可以复用同一套思路。